把大模型训推优化串起来
为了准备一次组会分享,我从训练与推理的区别讲起,把 FlashAttention、MLA、KDA、KV Cache、模型量化和推测解码串成了一张可以顺着读下去的地图。
为了准备一次组会分享,我先写了一份很粗的大纲。上面排着一串当时看起来很厉害的名字:FlashAttention、GQA、MLA、KDA、PagedAttention、QServe、推测解码……每个词我都大概听过,可真要站在一张架构图前,从第一根箭头讲到最后一个模块,我发现自己并没有想明白。
导师对分享的要求也很具体:论文来自哪里、哪一年、发在哪、有没有开源、用了什么数据和工作负载,都要核实。这个要求反而帮了我。它迫使我离开“某方法提升了几倍”这种二手结论,回到论文原文,看清楚它究竟改了哪一项成本,数字又是在什么条件下测出来的。
后来那份 PPT 做成了 19 页。本文沿用它的顺序,但把页面上放不下的前置知识补全。先说明范围:训推优化同时包含训练和推理,而我这次学习的主线更偏推理服务。FlashAttention 等方法也会帮助训练,但后面的 KV Cache、服务调度、量化和推测解码,主要讨论模型部署以后怎样更快、更省地生成文本。
文中出现的加速数字都来自各论文自己的模型、硬件和工作负载,只能说明方法在对应配置里有效,不能直接拿来排排行榜。
先把一次推理拆开
大语言模型读写的基本单位叫 token。它可能是一个汉字、一个英文词的一部分,也可能是标点。模型每一步根据已经出现的 token,预测下一个 token 的概率分布;新 token 加到末尾以后,再进入下一轮。这个过程叫自回归生成。
训练时,模型会在大量完整序列上做前向计算和反向传播,更新参数,同一序列里的许多位置可以并行处理。推理时参数已经固定,最麻烦的是生成阶段:第 t 个 token 必须等前面的结果确定以后才能继续,时间维度天然串行。
一次常见的推理请求还可以分成两个阶段:
| 阶段 | 模型在做什么 | 常见瓶颈 | 常看指标 |
|---|---|---|---|
| Prefill | 一次读完整段提示词,为所有输入位置计算表示 | 矩阵计算、Attention 算子 | TTFT(首 token 延迟) |
| Decode | 每轮只生成一个新 token,反复读取历史状态 | 显存容量、显存带宽、调度 | TPOT(每 token 延迟)、吞吐、p99 |
Attention 会把每个 token 映射成 Query、Key 和 Value。可以先把它们理解成“我现在要找什么”“历史内容的索引”和“历史内容本身”。生成到后面时,旧 token 的 Key 和 Value 不会再变化,所以没必要每轮重算;系统把它们保存下来,这就是 KV Cache。
这一步是我理解后面所有方法的起点:大模型推理不只是“算得多”,还在不断保存、读取和搬运越来越大的状态。
第一条线:KV Cache 要搬得少、存得少、放得聪明
KV Cache 的容量可以粗略写成:
2 × batch × 序列长度 × 层数 × KV 头数 × 每个头的维度 × 每个数的字节数最前面的 2 代表 Key 和 Value 两份状态。batch、上下文、模型层数或 KV 头数只要有一项变大,缓存都会跟着增加。长上下文服务里,KV Cache 很快就会从辅助数据变成主要显存开销。
我最后把这一组方法记成三句话:算子层让数据搬得更少,架构层让状态存得更少,系统层让缓存放得更聪明。
FlashAttention:少在仓库和操作台之间往返
GPU 的 HBM 可以理解成大仓库,容量大,但离计算单元较远;片上 SRAM 像很小的操作台,放不下多少东西,带宽却高得多。普通 Attention 会生成两个随序列长度平方增长的中间矩阵,并在不同 kernel 之间反复写回、读出 HBM。
FlashAttention 把 Q、K、V 分块搬进 SRAM,在小块内部完成打分、在线 softmax 和输出累加。中间的完整注意力矩阵不再落到 HBM,多个步骤也能融合进更少的 kernel。图从左往右正好对应“存储层级—分块循环—融合后的耗时”。
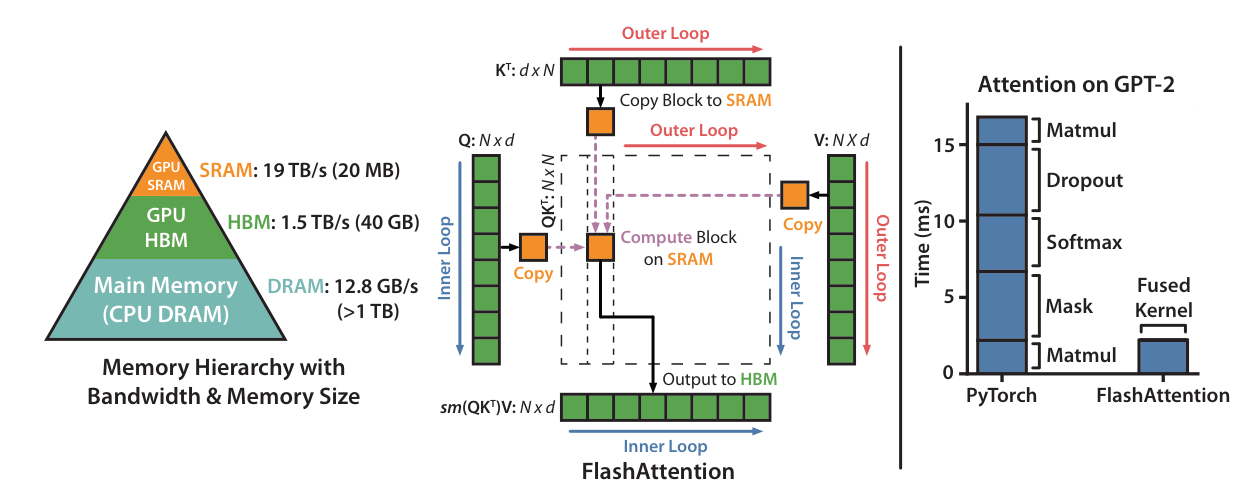
这里最容易记错的一点是:FlashAttention 没有把精确 Attention 的算术复杂度从二次变成线性。它减少的是中间矩阵物化和 HBM IO,计算结果仍是精确注意力。论文配置里的注意力算子示例最高达到 7.6×,但这个数字和序列长度、GPU、实现版本都有关。
FlashAttention-2:把 Q 块换到外层
前面介绍的是 FlashAttention v1。它已经解决了“不要把完整注意力矩阵写回 HBM”的大问题,但还没有把 GPU 上的工作分得足够好。v1 的前向算法把 K/V 的列块放在外层循环,把 Q 的行块放在内层循环:先取一块 K/V,再依次与所有 Q 块计算。这样容易复用 K/V,却意味着同一个 Q 块对应的输出 O、行最大值和 softmax 归一化统计,要随着每一块 K/V 反复从 HBM 读出、更新、再写回。
这个循环顺序还带来一个并行度问题。v1 主要沿 batch 和 attention head 分配 thread block;长序列往往伴随较小的 batch,如果 batch × head 不够大,一部分 GPU SM 就吃不到工作。算法减少了 IO,硬件却不一定跑满。
FlashAttention-2 最关键的改动正是调换内外循环:外层改为 Q 的行块,内层遍历 K/V 的列块。每个 thread block 独立负责一块 Q,把对应的输出和 softmax 状态一直留在片上,等所有 K/V 块处理完再一次写回。不同 Q 块之间互不依赖,于是序列长度本身也成为可以并行的维度。代价是不同 Q 块可能重复读取 K/V,但换来的并行度和更少的输出状态读写通常更值。
| 版本 | 外层 / 内层循环 | 主要不足或收益 |
|---|---|---|
| FlashAttention v1 | 外层 K/V,内层 Q | K/V 复用直观,但 Q 的输出与 softmax 状态反复进出 HBM;并行度主要来自 batch 和 head |
| FlashAttention-2 | 外层 Q,内层 K/V | 每个 Q 块独立并行,输出状态留在片上直到结束;长序列、小 batch 时更容易提高 GPU occupancy |
v2 还减少了昂贵的非矩阵乘 FP32 操作,并把 warp 间分工从需要合并部分结果的 split-K 改成 split-Q,让各 warp 直接负责不同 Q 切片,少做共享内存通信。论文在 A100 的对应配置中报告相对 v1 约 2×,达到理论峰值约 50%–73%;这仍然是特定 head dimension、mask 和硬件下的结果,不能当成所有模型固定翻倍。
GQA / MQA:减少 Key 和 Value 的副本
多头注意力里的“头”,可以理解成多组并行的注意力视角。传统 MHA 为每个 Query 头配一组独立的 Key 和 Value,表达能力充分,KV Cache 也最大。
MQA 走到另一个极端:所有 Query 头共享一组 K/V,缓存最省,但共享约束最强。GQA 位于中间,把 Query 头分组,每组共享一组 K/V。图中蓝色 Query 数量没有减少,减少的是粉色 Key 和黄色 Value。
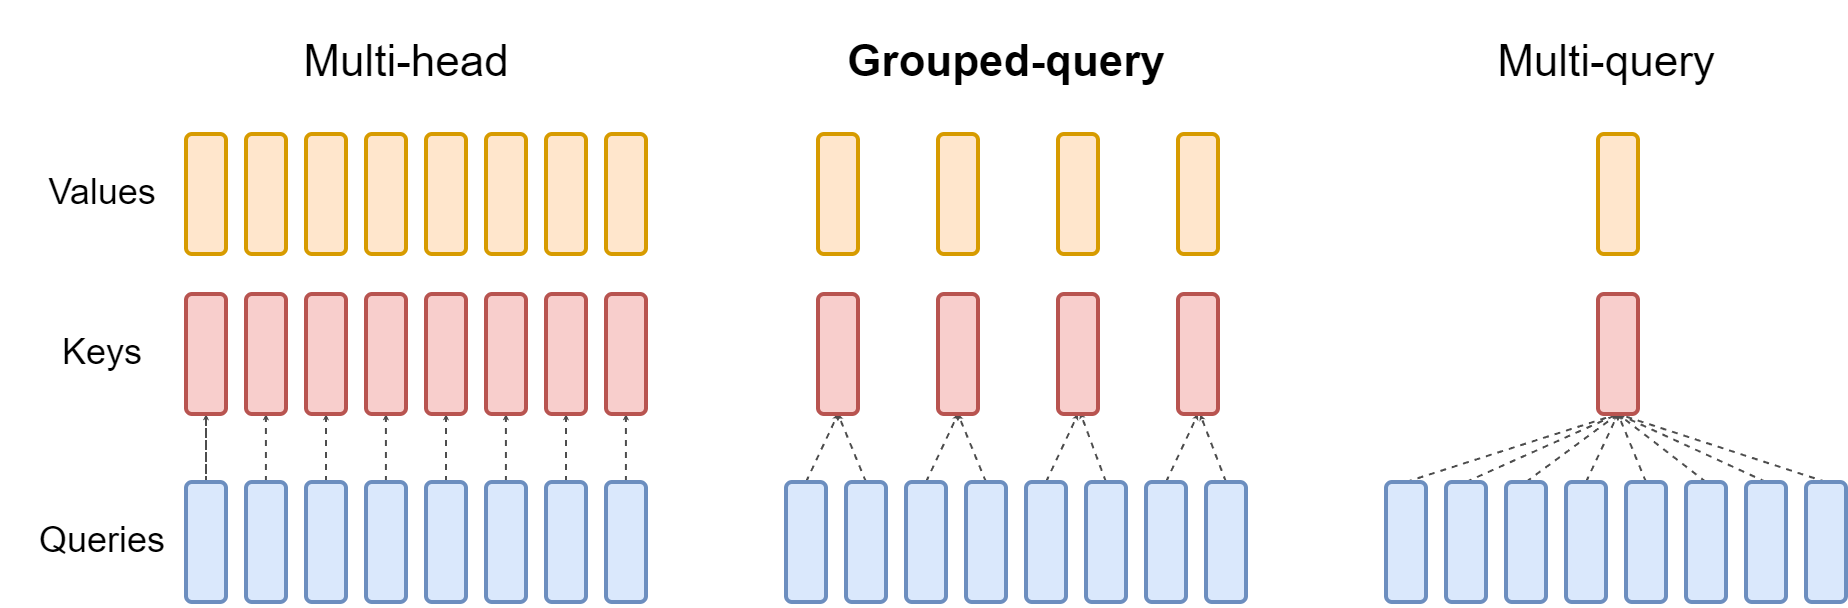
我习惯把它比作几位读者仍然各自提问,但开始共用参考资料。GQA 用约原预训练算力 5% 的 uptraining,把 MHA 检查点转换成分组结构;论文报告的目标是质量接近 MHA、速度接近 MQA,而不是宣称所有分组数都同样好。
MLA:不再缓存完整的 Key 和 Value
GQA 的思路是在完整 K/V 头的数量上做减法;MLA(Multi-Head Latent Attention)问得更进一步:推理时真的需要把每个头的完整 K 和 V 都存下来吗?
MLA 先把当前 token 的隐藏状态通过一个向下投影,压成维度更小的潜向量 c_kv。进入 KV Cache 的主要是这份压缩表示;真正计算注意力时,再通过向上投影得到各个头需要的 K 和 V。概念上可以把它理解成不再为每位读者保存一整套参考资料,而是保存一份压缩底稿,需要时再投影成不同视角。
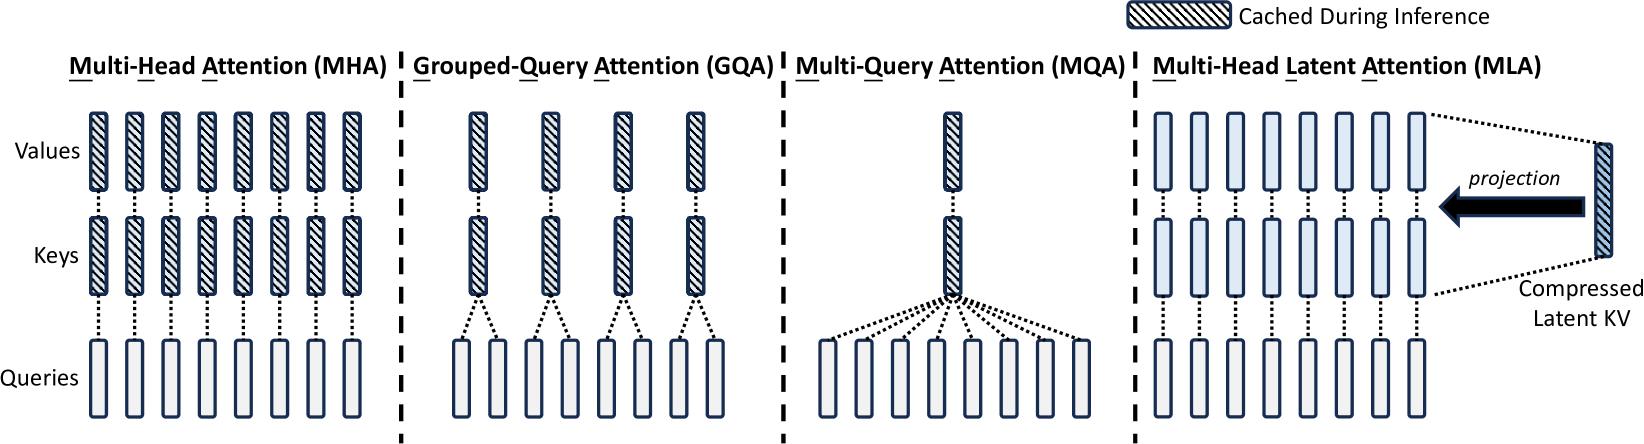
如果每次都显式解压全部 K/V,省下的显存可能又换成新的计算开销。MLA 的另一个关键是矩阵吸收:K 的向上投影可以提前吸收到 Q 的投影矩阵里,V 的向上投影也可以与输出投影合并。这样注意力计算可以直接围绕压缩向量进行,不必真的在显存里还原一份完整多头 K/V。
RoPE 又让事情多了一层。位置旋转与普通低秩投影不能随意交换顺序,因此 DeepSeek-V2 把负责位置的信息从 K 中单独拆出来。最终每个历史 token 需要缓存两部分:压缩的 latent KV,以及一小段带 RoPE 的 key。前者负责内容,后者负责位置;这也是只说“MLA 缓存一个低维向量”还不够完整的原因。
在 DeepSeek-V2 的配置里,论文给出的每 token KV Cache 规模约等于只有 2.25 个分组的 GQA。论文的同规模 MoE 对照中,小模型每 token 缓存元素从 MHA 的 110.6K 降到 15.6K,大模型从 860.2K 降到 34.6K,同时没有表现出系统性的能力下降。这里仍要注意:MLA 不是给现成 MHA 检查点随手加上的压缩插件,低秩投影、解耦 RoPE 和对应 kernel 都要成为模型与推理引擎的一部分。
我觉得最值得记住的区别是:GQA 改的是“保存几套 K/V”,MLA 改的是“到底保存什么”。
我补这一部分时参考了这篇中文原理解读,再回到 DeepSeek-V2 技术报告核对了缓存对象、矩阵吸收和实验数字。中文讲解适合顺着推导读,论文更适合确认边界。
KDA:把不断增长的 KV 变成一块可改写的状态
MLA 仍然属于 softmax 全注意力:它让每个 token 留下的缓存更小,但历史越长,压缩后的 KV 还是会一项项追加。读到 KDA(Kimi Delta Attention)时,我才意识到问题还可以再往前推一步:能不能不再为每个历史 token 留一份独立记录,而是把整段历史更新进一块固定大小的状态?
先看最简单的线性注意力。省略特征映射和归一化后,它可以把过去的 Key/Value 累加进一个状态矩阵 :
这样,输出只需要让当前 Query 去读取 ,状态大小不再随序列长度增长,对序列长度的 attention 计算也从二次变成线性。问题是这个状态像一张反复写字、从不擦除的纸:新旧关联不断叠在一起,写错的内容无法修正,相近的 Key 还会互相干扰。上下文越长,固定容量的状态越容易被“写花”。
KDA 的核心不是只给这张纸加一个统一的遗忘速度,而是同时引入逐通道遗忘门和 delta 修正。把论文公式改写成更容易读的三步,大致是:
是一个向量,每个特征通道都能决定自己保留多少旧状态; 控制这次写入有多强。第二行的 就是 delta:先用旧状态预测当前 Key 应该对应什么 Value,再只把“真实值与旧预测的差”写回去。换句话说,KDA 不再只有累加,还能沿当前 Key 的方向修正旧关联。相比 Gated DeltaNet 对整个 head 使用一个衰减值,KDA 把遗忘细化到了通道级,有限状态里的空间因此能分配得更精细。
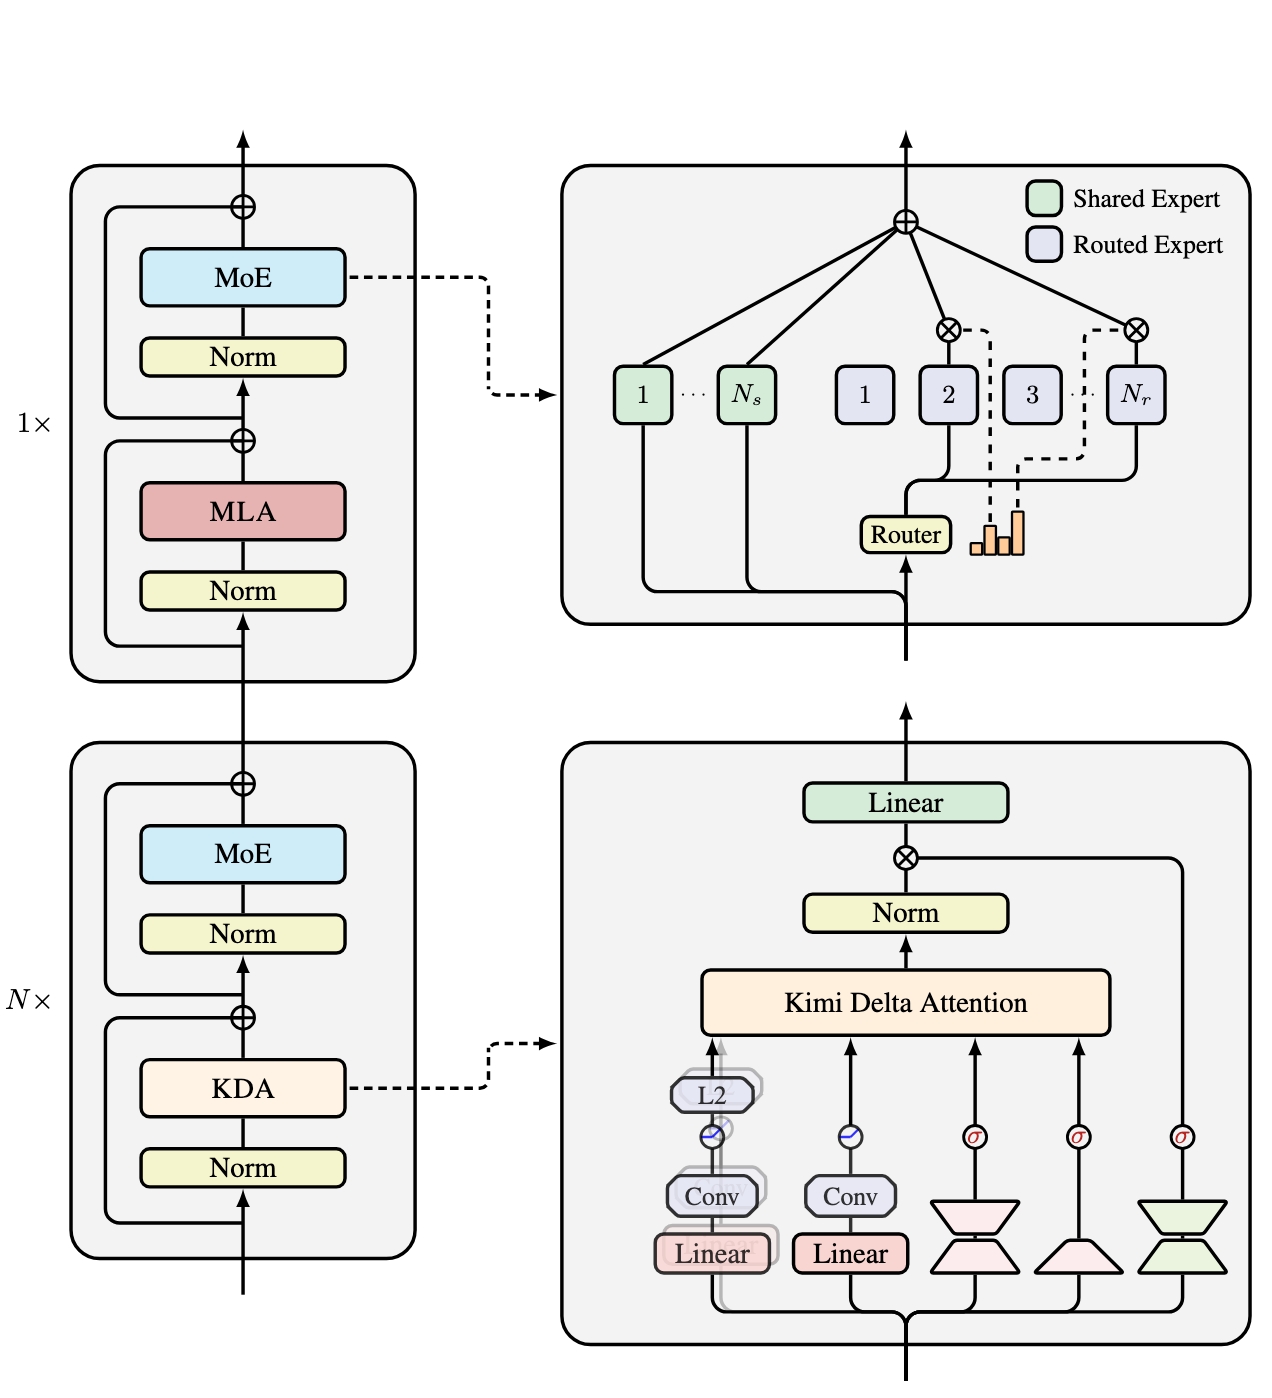
固定状态换来了效率,也带来了边界:纯线性注意力很难像完整 softmax 注意力那样,随时精确翻回某个很早的位置做复制或检索。Kimi Linear 没有假装这个问题不存在,而是采用混合架构:连续 3 层 KDA 负责高效处理大部分上下文,再插入 1 层完整 MLA 提供全局注意力。KDA 层的状态不会按 token 追加,MLA 层仍保留 KV Cache;所以论文所说的是整个模型的 KV Cache 最高减少约 75%,不是缓存彻底消失。
递推公式适合逐 token 解码,放到训练和 Prefill 中却容易重新变成串行瓶颈。KDA 把状态转移写成一种特殊的 DPLR(Diagonal-Plus-Low-Rank)形式,再用 chunkwise 算法把一段 rank-1 更新打包成矩阵运算,使更多工作能落到 Tensor Core 上。对我来说,这部分最重要的提醒是:数学上写出 还不够,能否把递推改造成 GPU 擅长的并行计算,才决定它是不是一个真正可用的架构。
Kimi Linear 技术报告用 48B 总参数、3B 激活参数的 MoE 做了同配方对比。相对完整 MLA,论文在 1M 上下文下报告最高约 75% 的 KV Cache 节省和约 6× 的解码吞吐;而 Figure 7 的 batch=1 测试里,1M 长度的 Prefill 是 2.9×,Decode TPOT 是 2.2×。这两个数字并不矛盾,反而再次说明 batch、指标与测量方式会显著改变“加速几倍”的含义。
我最后把三者记成一句话:GQA 减少完整 K/V 的份数,MLA 压缩每个 token 要保存的内容,KDA 则把整段历史改写进固定状态,再用少量 MLA 层补回全局精确检索。 这一节先顺着这篇 KDA 中文解析理解动机,再用 Kimi Linear 官方技术报告核对公式、混合比例和实验边界。
PagedAttention:序列连续,显存不必连续
早期服务系统常按最大长度为每个请求预留一整段连续显存。请求实际长度不可预知,短请求会浪费空间,长请求又可能频繁搬迁;不同长度的请求混在一起,还会产生碎片。
PagedAttention 借用了操作系统分页的思路:token 序列在逻辑上仍连续,但 KV 被切成固定大小的 block,block table 再把逻辑块映射到显存中不连续的物理块。新 token 到来时追加一块即可,共享前缀和 beam search 也能通过 copy-on-write 复用已有块。
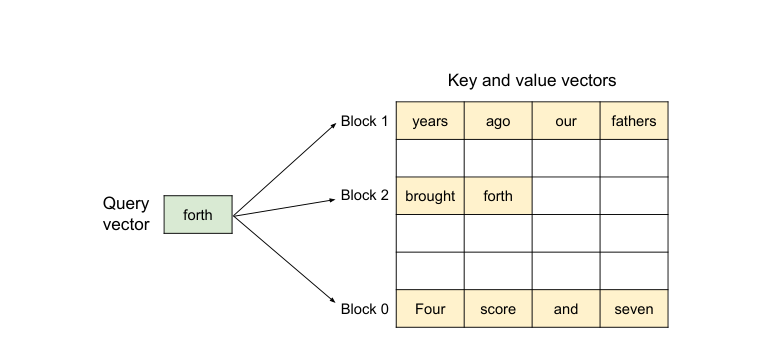
它改变的是内存管理,不是模型本身。vLLM 论文在相近延迟目标下报告约 2–4× 的服务吞吐提升;实际效果还取决于 block 大小、请求分布、continuous batching 和尾延迟目标。
Mooncake:让 Prefill 和 Decode 不再抢同一批 GPU
Prefill 更吃计算,Decode 更吃 KV 读取带宽。把两种工序固定塞进同一批 GPU,资源很难同时配平。Mooncake 把它们拆成两个资源池:上方 Prefill 节点负责读提示词并生成 KV,下方 Decode 节点取回 KV 后继续逐 token 生成。
中间的 Distributed KVCache Pool 由 CPU、DRAM、SSD 等资源组成,KV 可以通过 RDMA 在节点之间迁移和复用;左侧 Conductor 根据缓存命中、负载和 SLO 决定请求去哪里。
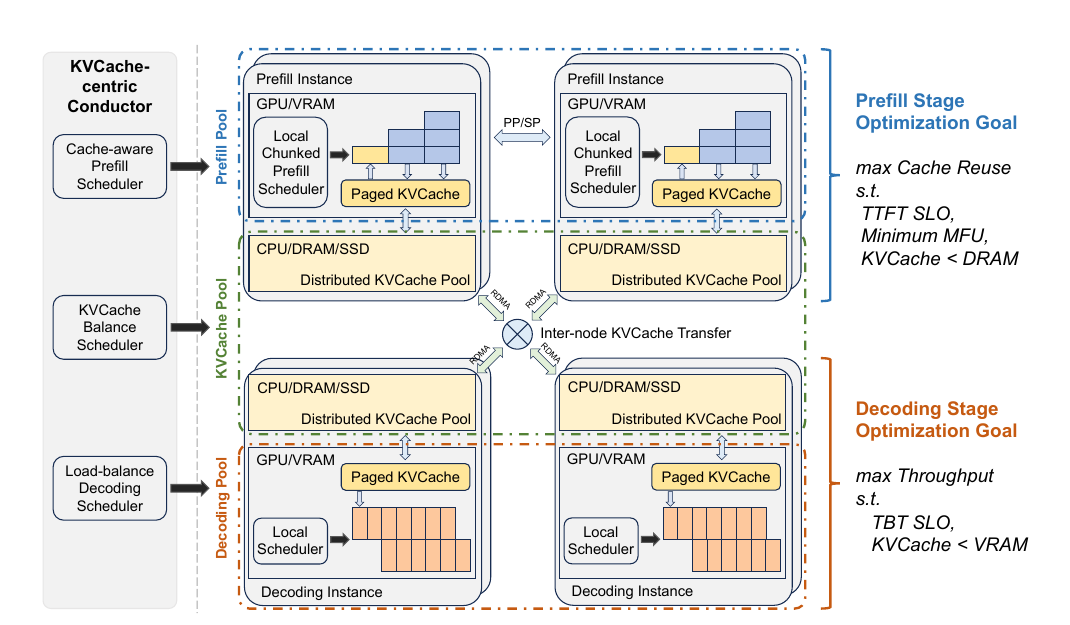
在论文的 23,000 条真实请求 trace 中,Mooncake 在满足 SLO 时处理请求数约提升 75%。这类方法的代价也很明确:系统复杂度转移到了网络、缓存命中率、跨节点传输和调度上。上下文越长、复用越高,它越有机会发挥作用。
第二条线:量化是在省容量,也是在匹配硬件
量化是把原本很细的数值刻度换成更少的格子。例如 FP16 用 16 bit 表示一个数,INT8 用 8 bit,INT4 只用 4 bit。位数降低以后,模型占用更小、数据搬运更少,合适的硬件还能直接执行低比特矩阵乘。
但“一个四比特模型”这句话经常说得太笼统。需要先问清楚压的是哪一种数据:
| 对象 | 含义 | 降低位数主要解决什么 |
|---|---|---|
| W(权重) | 模型长期保存的参数 | 模型体积与权重读取 |
| A(激活) | 每层计算时产生的临时结果 | 矩阵乘算力和中间带宽 |
| KV | 生成过程中保存的历史状态 | 长上下文容量与 Decode 读取 |
训练完成后再用校准数据决定量化尺度,叫 PTQ;训练时就模拟低比特误差并调整参数,叫 QAT。PTQ 部署成本低,QAT 通常更重。无论哪种路线,位数越低,离群值和数值范围越难处理,最终都要回到任务质量验证。
QServe:W4A8KV4 不是随便写的三个数字
QServe 为权重、激活和 KV 选择了不同精度。图中绿色是 INT4,橙色是 INT8,红色保留 FP16:权重用 4 bit 减少小 batch Decode 的读取,激活保持 8 bit 以使用 INT8 Tensor Core,KV 再用 4 bit 缩减长上下文缓存。
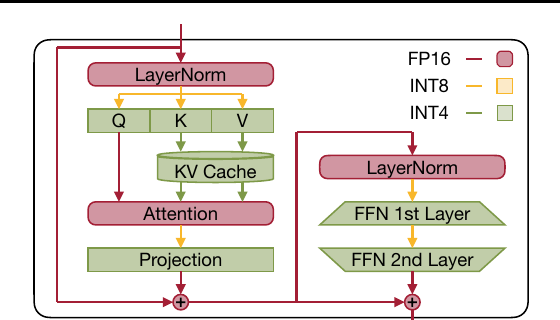
它还做了两件很工程化的事。Progressive group quantization 在 kernel 内逐步把 W4 转成适合 INT8 计算的表示,避免完整反量化回 FP16;SmoothAttention 先处理 Key 中固定出现的异常通道,减轻 KV4 的精度压力。论文在 A100、L40S 和不同规模模型上报告 1.2–3.5×,同时强调收益依赖 GPU 指令、模型规模、batch 与 kernel 支持。
FlatQuant:先把高低不平的分布摊平
如果少数通道特别大,其余通道很小,同一套四比特刻度很难照顾两边。FlatQuant 在线性层的激活侧乘一个可逆变换 P,权重侧乘对应的逆变换;两者在矩阵乘里相互抵消,层的数学输出不变,权重和激活的通道分布却变得更平。
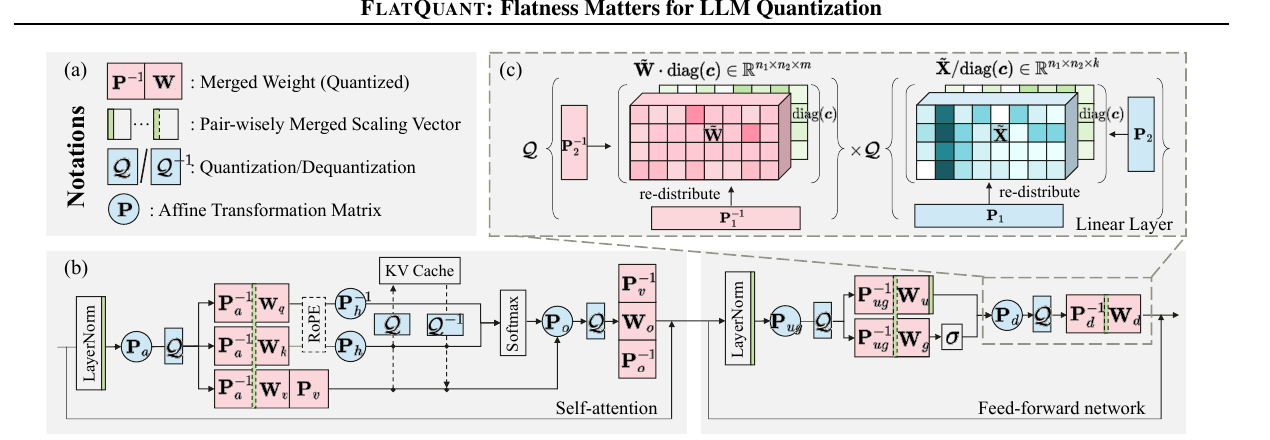
这不是删除离群值,更像把几座特别高的山摊成较平的丘陵,再拿粗尺子测量。为了控制成本,论文用 Kronecker product 把大变换拆成更小的结构化矩阵,并把变换、缩放和量化融合进 kernel。论文配置中,LLaMA-3-70B 的 W4A4 精度下降小于 1%,Prefill 最高 2.3×、Decode 最高 1.7×;代价是校准、学习变换参数和自定义 kernel。
第三条线:推测解码减少的是串行轮数
普通自回归生成每轮只确认一个 token。即使 GPU 很快,大模型也要一轮接一轮启动。推测解码的基本流程可以概括成三步:
- 便宜的 Draft 路径先提出一小段候选;
- Target 大模型在一次前向里并行检查多个候选位置;
- 从前往后接受连续通过的前缀,遇到第一个不符合规则的位置就停止并继续生成。
在 greedy 或 speculative sampling 的正确接受规则下,最终输出或概率分布仍由目标模型决定。它不是让小模型取代大模型,而是让大模型一次批改更多内容。收益取决于一笔账:草稿够不够便宜、候选够不够准、一次能接受多长,以及并行验证有没有浪费太多计算。
Medusa:从同一个隐藏状态长出多个预测头
Medusa 不额外维护一个完整草稿模型,而是在目标模型最后的隐藏状态旁边接多个轻量 decoding heads。不同 head 预测不同未来位置的 Top-k 候选,这些候选组成一棵树,再由 Tree Attention 一次验证多条路径。
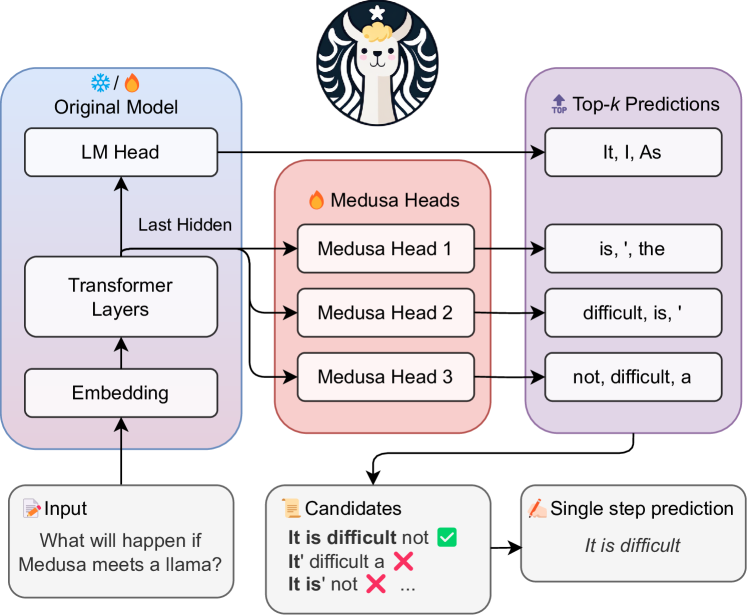
Medusa-1 冻结 backbone、只训练 heads;Medusa-2 联合微调 backbone 与 heads。技术报告摘要分别给出超过 2.2× 和 2.3–2.8×。它省掉了独立 draft model,但多个未来位置主要独立预测,位置间依赖建模较弱,而且每个目标模型都需要配套 heads。
DFlash:一次填满一块空位
DFlash 把草稿生成改成 block diffusion:输入中放入一段 mask token,轻量 drafter 通过双向注意力,在一次前向中并行填满整个 token block。图中的蓝色块是从目标模型多层提取并融合的上下文特征,它们被注入每个 draft layer,帮助轻量模型理解上下文;绿色是尚未填完的 mask,黄色是已经确定的 token。
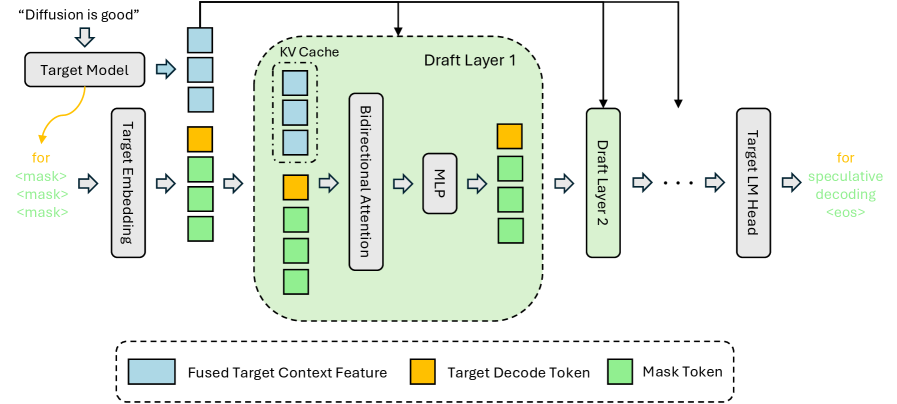
论文配置报告跨模型和任务超过 6× 的无损加速。它的难点也来自“同时填”:块内 token 缺少显式前后依赖,越靠后的位置可能越不可靠,所以 block 长度、draft 层数、接受率和验证开销必须一起调。
DSpark:先并行猜,再快速顺一遍
DSpark 位于逐 token 草稿和完全并行草稿之间。图按 1、2、3 阅读:目标模型先给出锚点 D;Parallel Block 一次产生后续位置的候选表示;Sequential Block 用很轻的顺序模块让后一个位置看到前一个候选,补回 E、F、G、H 的块内依赖。
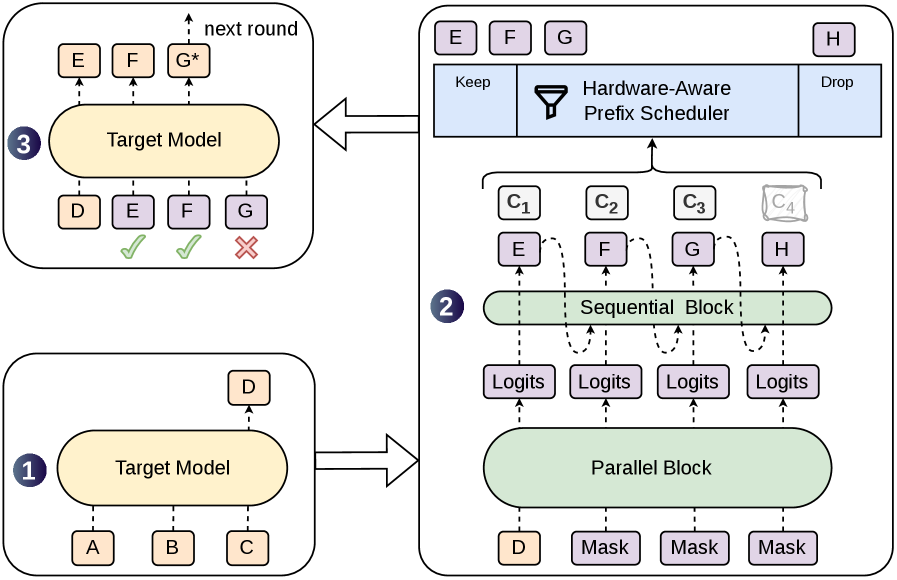
每个候选还有置信度,Hardware-Aware Prefix Scheduler 会结合置信度与真实引擎的吞吐曲线,提前丢掉把握不足的后缀。论文在 DeepSeek-V4 真实流量中报告:相对 MTP-1,在匹配吞吐水平下单用户速度提升 60%–85%。截至项目核验时它仍是 arXiv 工作,没有把它写成已经正式发表的会议论文。
如果想把平均接受长度、半自回归 head 和硬件感知调度器继续拆开看,可以接着读弥野的《解读 DSpark: Confidence-Scheduled Speculative Decoding with Semi-Autoregressive Generation》。它从“每 token 平均延迟由 draft 成本、验证成本和平均接受长度共同决定”这笔账出发,把正文里略过的公式、后缀衰减与调度细节补得更完整。
三条线放在一起,先问“瓶颈在哪里”
把论文逐篇看完以后,我不再先背方法名,而是先问它移动了哪一项成本。
| 路线 | 主要改什么 | 对质量的影响 | 最需要复测什么 |
|---|---|---|---|
| KV Cache / 系统优化 | IO、KV 头数或潜向量、内存分配、缓存池和调度 | 精确算子与系统方法通常保持输出;GQA、MLA 需要对应的模型结构 | 容量、带宽、命中率、网络、尾延迟 |
| 模型量化 | 权重、激活和 KV 的数值精度 | 可能有小幅误差 | 校准集、任务质量、低比特 kernel 与硬件兼容性 |
| 推测解码 | 目标模型的串行调用次数 | 正确接受规则下保持目标输出或分布 | draft 成本、接受率、验证浪费、batch 与上下文 |
这也解释了为什么不同论文的峰值加速不能横向比较。FlashAttention 的 7.6× 是某个注意力算子示例,PagedAttention 的 2–4× 是服务吞吐,Mooncake 的 75% 来自真实 trace 下满足 SLO 的请求量,DSpark 的 60%–85% 又是在匹配吞吐后的单用户速度。指标、基线和工作负载都不一样。
如果真的要优化一个服务,我会按下面的顺序做:
- 固定基线。 记录模型、GPU、batch、输入输出长度、精度、TTFT、TPOT、吞吐、显存和 p99。
- 先 profile。 分清问题发生在 Prefill 计算、Decode 带宽、KV 容量,还是排队与调度。
- 降低常驻成本。 评估 GQA、权重量化、激活量化和 KV 量化,并先验证质量与 kernel 支持。
- 整理算子和缓存路径。 使用 FlashAttention、PagedAttention、continuous batching;需要时再考虑 Mooncake 式分离服务。
- 最后评估推测解码。 在稳定基线上测接受率、平均接受长度、验证浪费、尾延迟和吞吐。
组合收益不能直接相乘。量化改变 kernel 的计算/带宽比例,分离式服务改变调度和网络,推测解码又会改变 batch 与验证形态;每加一层,都要在同一套工作负载上重测。
这次学习让我改掉的三个习惯
第一个习惯,是看到模型慢就只想到 FLOPs。FlashAttention 和 Mooncake 让我意识到,很多时候计算单元没有忙满,数据还在路上。先判断计算受限还是带宽受限,比直接换一个“更快”的算法更重要。
第二个习惯,是把“四比特模型”当成一句完整描述。现在我会继续问 W、A、KV 各是多少位,矩阵乘实际走什么指令,反量化放在哪里,质量用什么任务测。
第三个习惯,是把推测解码理解成“小模型替大模型生成”。真正决定输出的仍是 Target;Draft 只是提出候选。方法之间的差别,主要在草稿怎样产生、怎样表达位置依赖,以及怎样选择送去验证的长度。
这条研究线还在快速变化。模型架构会从 GQA、MLA 继续走向 KDA 这类混合线性注意力,以及 CLA、YOCO 等更少 KV 的设计;KV Cache 会变成可以压缩、迁移、跨请求复用的分布式内存层;量化精度、draft 长度、kernel 和调度也会越来越动态。无论方法怎么换,端到端、可复现的 benchmark 仍然是底座。
回头看这次学习,我真正得到的不是十二篇论文与技术报告的摘要,而是一张判断地图:这个方法在省什么,它把代价移到了哪里,论文数字在哪些条件下才成立。 有了这三个问题,再遇到一个新方法,至少知道应该从哪一页开始读。
文中论文与项目
| 方法 | 论文信息 | 开源状态 |
|---|---|---|
| FlashAttention | NeurIPS 2022 | Dao-AILab/flash-attention,BSD-3-Clause |
| FlashAttention-2 | ICLR 2024 | Dao-AILab/flash-attention,BSD-3-Clause |
| GQA | EMNLP 2023 | google/flaxformer,Apache-2.0,仓库已归档 |
| MLA / DeepSeek-V2 | arXiv:2405.04434 | deepseek-ai/DeepSeek-V2,MIT |
| KDA / Kimi Linear | arXiv:2510.26692 | MoonshotAI/Kimi-Linear,MIT |
| PagedAttention | SOSP 2023 | vllm-project/vllm,Apache-2.0 |
| Mooncake | USENIX FAST 2025 | kvcache-ai/Mooncake,Apache-2.0 |
| QServe | MLSys 2025 | mit-han-lab/omniserve,Apache-2.0 |
| FlatQuant | ICML 2025 | ruikangliu/FlatQuant,MIT |
| Medusa | arXiv:2401.10774 | FasterDecoding/Medusa,Apache-2.0 |
| DFlash | ICML 2026 / arXiv:2602.06036 | z-lab/dflash,MIT |
| DSpark | arXiv:2607.05147 | deepseek-ai/DeepSpec,MIT |
资料与论文状态按这次项目的核验结果整理,截止 2026 年 8 月 1 日。